Telco Churn & Pricing: quem vale a pena contatar para reter
Previsão de cancelamento em uma operadora (7.043 clientes) transformada em decisão: probabilidades calibradas, regra de ganho esperado para escolher quem contatar e fila de retenção com os motivos de cada cliente.
Contexto
Dataset público Telco Customer Churn (IBM Sample Data Sets), com 7.043 clientes, 21 colunas e 26,5% de cancelamentos. As premissas de custo e de sucesso da ação são ilustrativas, não vêm de uma operação real.
Problema
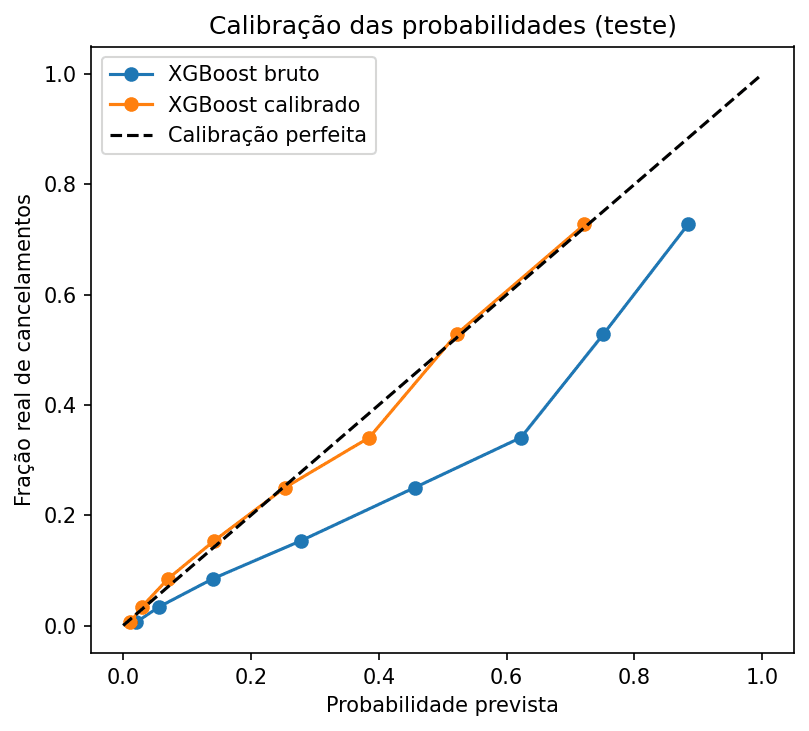
Saber a probabilidade de churn não diz quem vale a pena contatar: cada ação de retenção custa dinheiro, e o XGBoost com scale_pos_weight superestima as probabilidades, o que distorce qualquer conta de retorno.
Objetivo
Ir além da métrica do modelo: definir quem receber a ação de retenção pelo retorno esperado e mostrar o quanto essa conclusão depende das premissas.
Arquitetura da solução
Código modular em src/ (dados, features, regressão, classificação, interpretabilidade, avaliação e negócio), scripts de treino, notebook de EDA, testes automatizados e integração contínua no GitHub Actions. O calibrador é ajustado em previsões out-of-fold do treino e o teste é usado uma única vez, para medir.
Pipeline
- 1Dados brutos (CSV)
- 2Limpeza e EDA
- 3Pré-processamento (One-Hot, escala)
- 4XGBoost + baseline logístico
- 5Calibração (out-of-fold)
- 6Ganho esperado e fila de retenção
Processo técnico
- Análise exploratória do churn por contrato, tempo de casa, internet e pagamento
- Pré-processamento dentro de Pipeline do scikit-learn, sem vazamento entre treino e teste
- Baseline com Regressão Logística para comparar com o XGBoost
- Calibração Platt com previsões out-of-fold do treino e comparação de 6 estratégias de retenção no teste
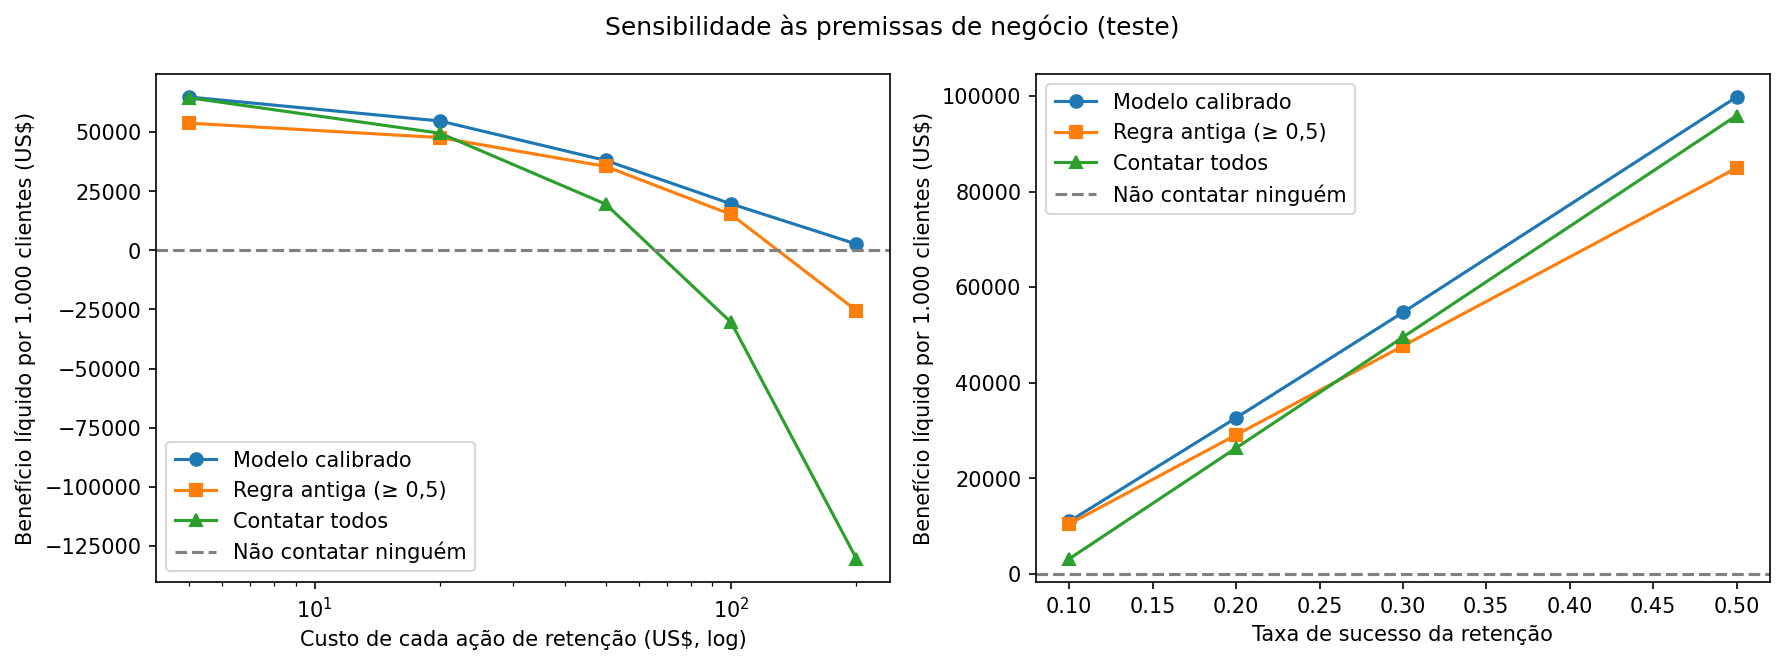
- Análise de sensibilidade ao custo da ação e à taxa de sucesso
- 29 testes automatizados (incluindo contas de ganho conferidas à mão) e lint com Ruff rodando em CI (Python 3.10 e 3.12)
Insights
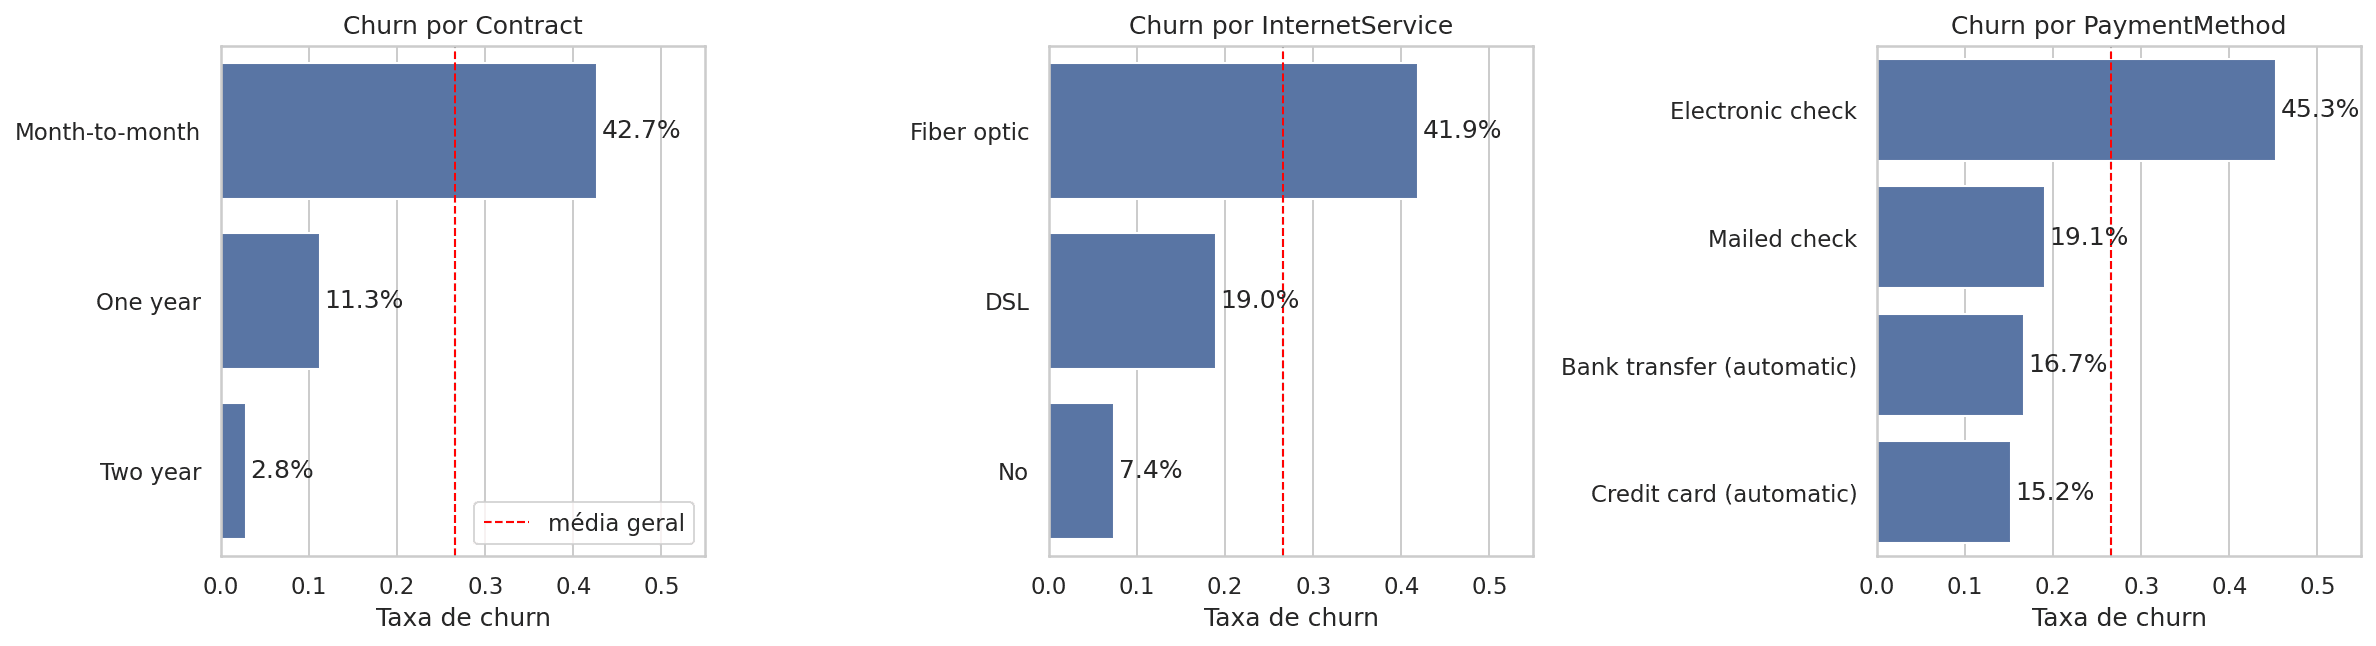
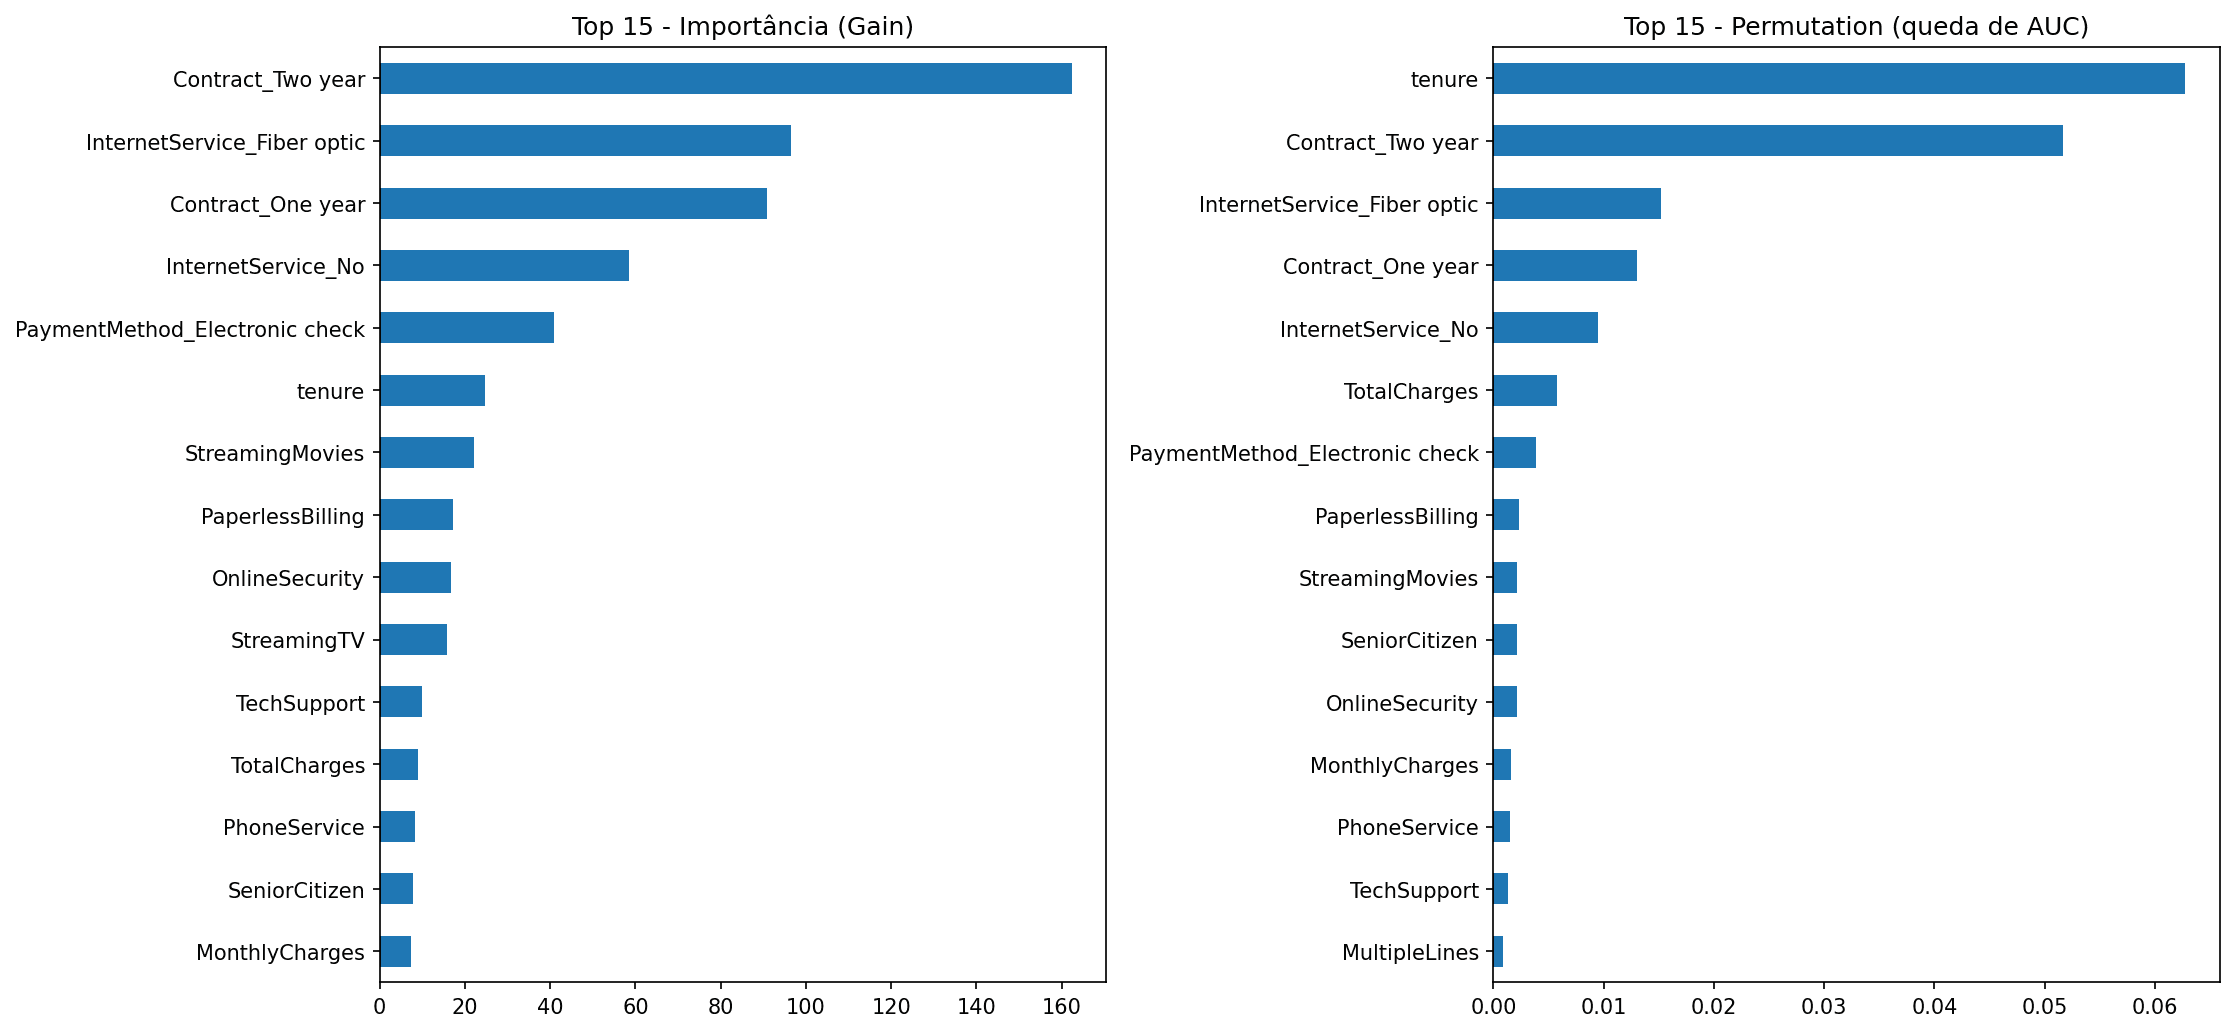
- O tipo de contrato é a principal alavanca de retenção: churn de 42,7% no plano mensal, 11,3% no anual e 2,8% no bienal
- O risco se concentra no primeiro ano: 47,4% de churn entre 0 e 12 meses de casa contra 9,5% após 49 meses
- Fibra ótica (41,9%) e cheque eletrônico (45,3%) merecem investigação de qualidade, suporte e atrito de pagamento
- A probabilidade bruta do XGBoost é inflada (média de 40,1% contra 26,5% de churn real); sem calibrar, a conta de retorno da campanha fica distorcida
- Com ação barata (US$ 5), contatar todos empata com o modelo; quanto mais cara a ação, maior a vantagem de escolher quem contatar
Resultados
Com premissas ilustrativas, a decisão por ganho esperado rende cerca de 15% a mais que o corte de 0,5 e cerca de 10% a mais que contatar todos os clientes (US$ 54,7 mil contra 47,7 mil e 49,5 mil por 1.000 clientes). A calibração leva a probabilidade média de 40,1% para 26,7%, perto do churn real de 26,5%.
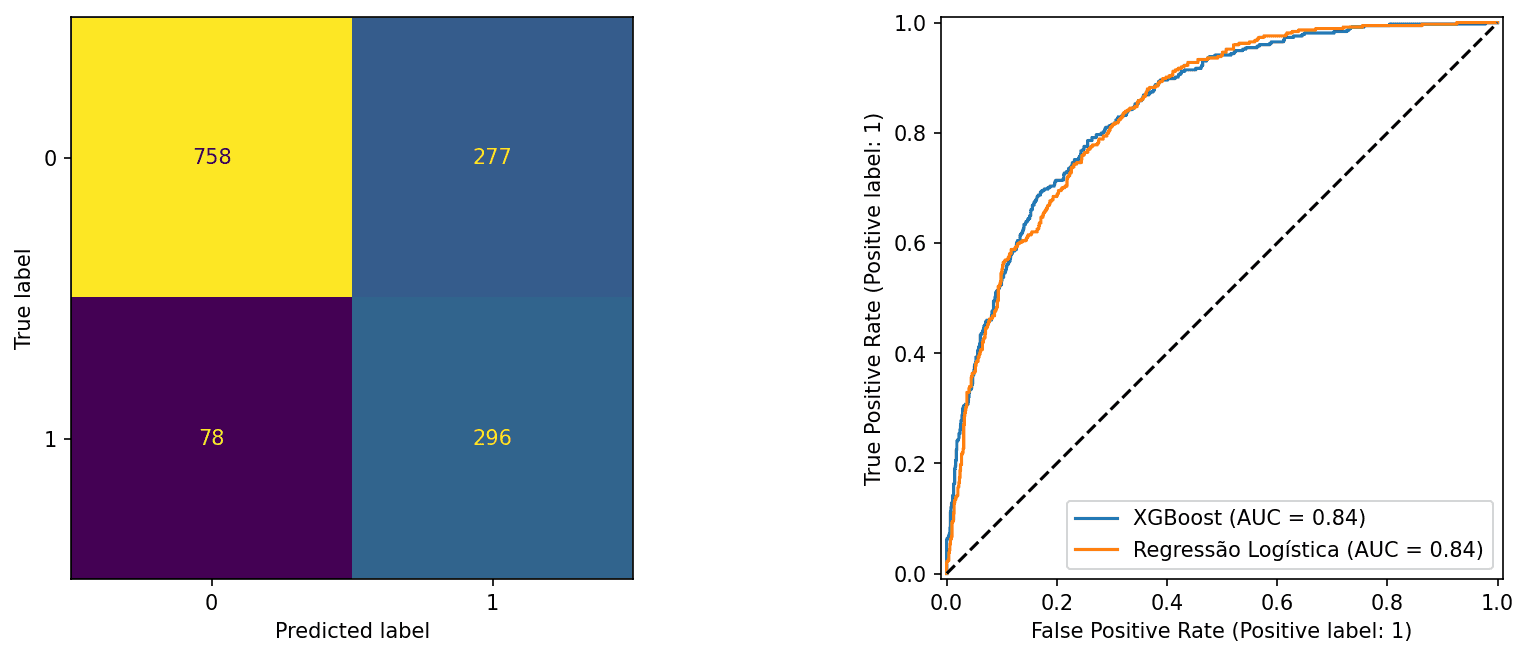
- Classificação: XGBoost com AUC-ROC de 0,845 no teste (0,846 ± 0,011 em CV), recall de 0,79 e precision de 0,52 no corte de 0,5
- Benefício por 1.000 clientes: US$ 54,7 mil (XGBoost calibrado), 47,7 mil (corte de 0,5), 49,5 mil (contatar todos) e 64,2 mil no limite teórico
- Com ação de US$ 200, a regra antiga dá prejuízo (−US$ 25,5 mil) e o modelo calibrado ainda fica positivo (US$ 2,6 mil)
- Leitura honesta: a Regressão Logística calibrada rende praticamente o mesmo (US$ 54,6 mil); o XGBoost empata com ela neste dataset
- Regressão de MonthlyCharges com R² de 0,999 redescobre a tabela de preços; o maior desvio é de US$ 4,84, então a lista de auditoria é fraca como detector de erro
Limitações
- Associação não é causalidade: confirmar o efeito de um desconto em contrato exigiria teste A/B
- O R² próximo de 1 reflete a precificação aditiva do dataset, não um problema difícil resolvido por ML
- Sem dados comportamentais, o teto de AUC do dataset fica perto de 0,85
- Custo da ação, taxa de sucesso (30%) e horizonte (12 meses) são premissas ilustrativas, e a receita em risco ignora margem e desconto
Visualizações
Projetos relacionados
Data-Vigil: detecção de anomalias em transações de cartão
Pipeline reprodutível para sinalizar transações potencialmente fraudulentas em uma base com apenas 0,17% de fraudes: avaliação sem vazamento, custo de negócio e explicabilidade do modelo.
Recomendador Multimodal: busca de produtos por imagem e texto com CLIP
Sistema de recomendação que encontra produtos parecidos a partir de uma foto, de uma descrição ou dos dois juntos: embeddings CLIP, busca por cosseno no ChromaDB, avaliação offline contra o acaso e app publicado no Streamlit.