Recomendador Multimodal: busca de produtos por imagem e texto com CLIP
Sistema de recomendação que encontra produtos parecidos a partir de uma foto, de uma descrição ou dos dois juntos: embeddings CLIP, busca por cosseno no ChromaDB, avaliação offline contra o acaso e app publicado no Streamlit.
Contexto
Dataset Fashion Product Images (versão small, Kaggle): amostra de 2.000 produtos, 1.999 após a validação das imagens. O dataset não tem preço; a coluna foi gerada de forma reprodutível e marcada como sintética.
Problema
Recomendar produtos parecidos quando o usuário tem uma foto ou uma ideia em palavras, e não o nome exato do item, e sem depender de histórico de compras ou de cliques.
Objetivo
Construir um recomendador multimodal ponta a ponta, do dado bruto ao app publicado, que funcione sem histórico de usuários e cuja qualidade seja medida contra o acaso, em vez de apenas parecer boa.
Arquitetura da solução
Cada produto tem um vetor de imagem e um de texto no mesmo espaço do CLIP. Duas coleções no ChromaDB (imagens e descrições) compartilham IDs e metadados. O buscador embeda a consulta com o mesmo modelo que indexou, consulta por cosseno e aplica os filtros de metadados na própria consulta. O app apenas lê o índice.
Pipeline
- 1Catálogo (CSV + imagens)
- 2Limpeza e imagens por ID
- 3Embeddings CLIP em lotes
- 4Índice ChromaDB (cosseno)
- 5Busca por texto, imagem ou ambos
- 6App Streamlit
- 7Avaliação offline
Processo técnico
- Limpeza do catálogo (IDs inválidos, duplicados e nomes ausentes) e padronização de cada imagem em RGB e até 512 px, nomeada pelo ID do produto
- Embeddings CLIP em mini-batches com gravação em memmap e checkpoints: a memória não cresce com o catálogo e uma execução interrompida retoma do último lote
- Vetores normalizados em L2 e índice HNSW em cosseno no ChromaDB, com metadados (nome, preço, tipo, cor e caminho da imagem) para filtrar na consulta
- Fingerprint (catálogo, modelo e dimensão) gravado no índice: impede misturar vetores de modelos diferentes, e o app lê o modelo a partir dos metadados da coleção
- Busca por texto, por imagem ou combinada (média ponderada normalizada dos dois vetores), com exclusão do próprio item em 'Ver similares'
- Avaliação offline com P@k, MRR e HitRate, intervalos de confiança de 95% e baseline aleatório, mais a comparação entre dois modelos CLIP
- 48 testes automatizados com pytest, cobrindo batching, retomada, indexação, busca, filtros, avaliação e o app
Insights
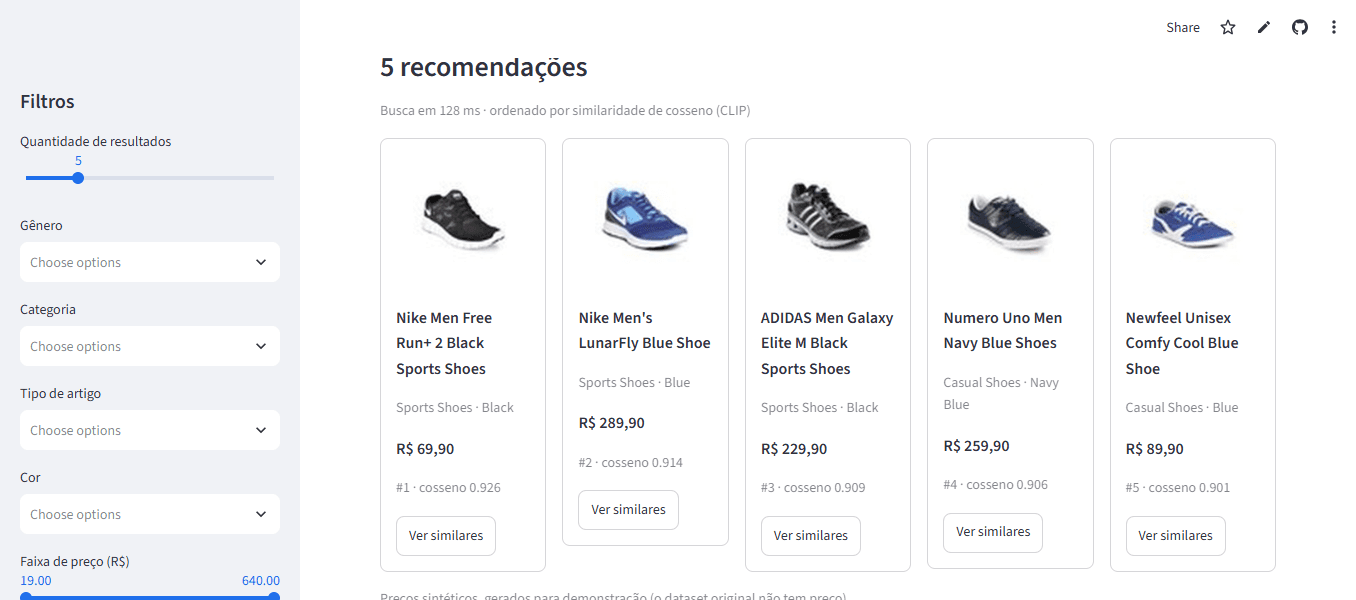
- O embedding visual acerta o tipo antes da cor: P@5 por tipo de 0,706 contra 0,232 por tipo e cor (acaso: 0,055 e 0,008)
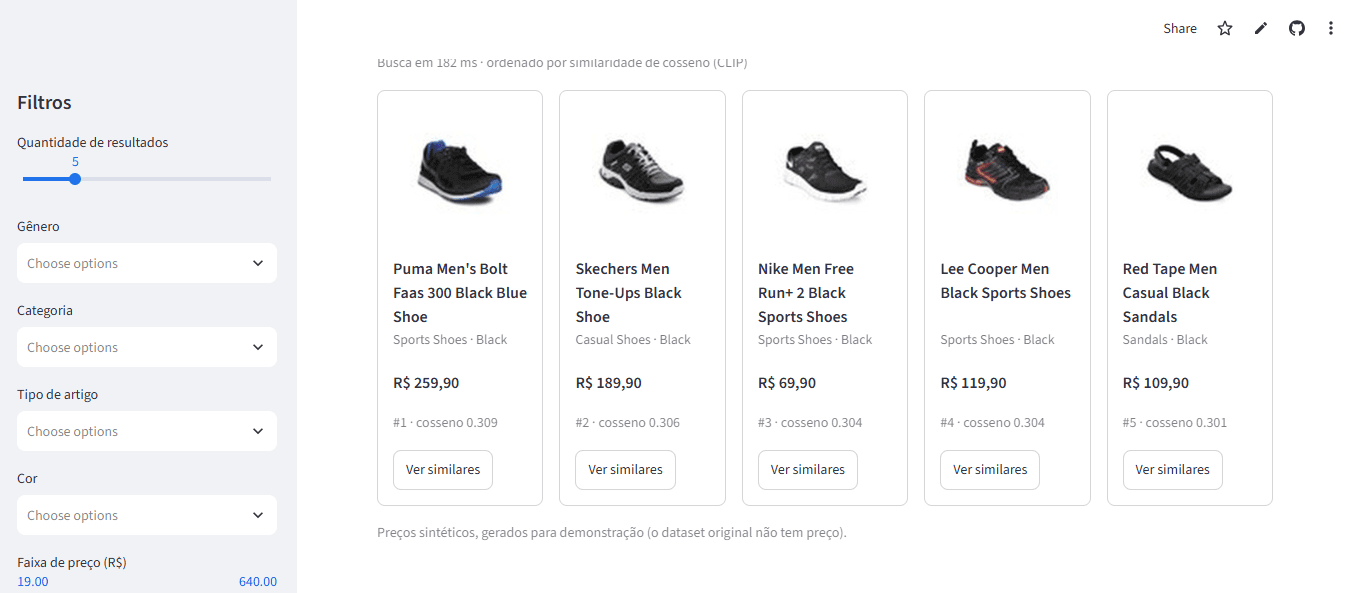
- A busca por texto funciona sem treinamento adicional: com um prompt curto como 'a photo of black sports shoes', P@5 por tipo de 0,665
- O modelo maior (ViT-L/14) não mostrou ganho comprovado: em nenhuma das 18 métricas os intervalos de confiança de 95% se separaram, e ele exige cerca de 1,7 GB de pesos contra ~600 MB do ViT-B/32; o app usa o ViT-B/32
- O experimento texto → descrição parece ir melhor, mas é circular: o texto indexado e os rótulos de relevância vêm dos mesmos campos do catálogo, então não prova melhor compreensão
- Ganhos de dezenas de vezes sobre o acaso aparecem porque o baseline é minúsculo (0,007 a 0,008); o valor absoluto é a referência mais honesta
Resultados
Em um catálogo de 1.999 produtos de moda, 70,6% dos 5 vizinhos visuais têm o mesmo tipo de artigo (acaso: 5,5%) e, na busca por texto, 89,6% das consultas trazem um produto do tipo e da cor certos entre os 10 primeiros (96 consultas, IC 95% de ±6,1 pontos).
- Imagem → imagem (500 consultas): P@1 de 0,748, P@5 de 0,706 (IC 95% de ±0,030) e MRR de 0,819 por tipo de artigo, contra 0,055 ao acaso; na categoria ampla, P@5 de 0,981
- Texto → imagem (96 consultas geradas a partir do catálogo): P@5 de 0,665 por tipo e de 0,462 por tipo e cor; HitRate@10 por tipo e cor de 0,896
- ViT-B/32 (512 dimensões) contra ViT-L/14 (768 dimensões) no mesmo catálogo e com as mesmas consultas: sem diferença estatisticamente separável; o ViT-B/32 foi o escolhido para o app
- App publicado no Streamlit Community Cloud, com filtros por gênero, categoria, tipo, cor e preço e busca na casa de 100 a 200 ms
Limitações
- A relevância vem dos metadados do catálogo (mesmo tipo de artigo; no critério estrito, também a mesma cor): é um proxy, itens de tipos diferentes podem ser substitutos razoáveis, e quase-duplicatas do catálogo inflam a precisão imagem → imagem
- A avaliação de texto tem só 96 consultas, com intervalos de confiança largos (cerca de ±5 a ±8 pontos)
- Os preços exibidos são sintéticos, gerados só para demonstração
- Catálogo pequeno (cerca de 2 mil produtos) e imagens de baixa resolução; consultas em inglês rendem mais, porque o CLIP original foi treinado majoritariamente nesse idioma
Visualizações
Projetos relacionados
Telco Churn & Pricing: quem vale a pena contatar para reter
Previsão de cancelamento em uma operadora (7.043 clientes) transformada em decisão: probabilidades calibradas, regra de ganho esperado para escolher quem contatar e fila de retenção com os motivos de cada cliente.
Data-Vigil: detecção de anomalias em transações de cartão
Pipeline reprodutível para sinalizar transações potencialmente fraudulentas em uma base com apenas 0,17% de fraudes: avaliação sem vazamento, custo de negócio e explicabilidade do modelo.