Data-Vigil: detecção de anomalias em transações de cartão
Pipeline reprodutível para sinalizar transações potencialmente fraudulentas em uma base com apenas 0,17% de fraudes: avaliação sem vazamento, custo de negócio e explicabilidade do modelo.
Contexto
Base pública Credit Card Fraud Detection (ULB/Kaggle): 284.807 transações de portadores europeus, com variáveis V1–V28 anonimizadas via PCA e apenas 492 fraudes (0,173%). Projeto com finalidade educacional.
Problema
Como identificar transações que fogem do comportamento esperado, minimizando tanto fraudes não detectadas quanto bloqueios indevidos de clientes legítimos, quando a fraude representa uma fração minúscula dos dados.
Objetivo
Construir o ciclo completo de ciência de dados sobre uma classe extremamente rara, tratando anomalias como sinais potenciais, e não como veredito automático de fraude.
Arquitetura da solução
O modelo gera um score de anomalia e o converte em faixa de risco (LOW, MEDIUM, HIGH, CRITICAL), tratada como recomendação de ação. O pipeline tem duas fases: a primeira usa só o treino para escolher modelo e thresholds; a segunda mede no teste, uma única vez. Modelo, thresholds e lista de features são serializados juntos.
Pipeline
- 1Limpeza e atributos
- 2Split treino/teste
- 3Modelos (LR, RF, XGBoost)
- 4Validação cruzada no treino
- 5Thresholds (F1 e custo) só no treino
- 6Medição única no teste
- 7Sensibilidade ao custo e SHAP
Processo técnico
- Split treino/teste antes de qualquer decisão; modelo e thresholds escolhidos só com probabilidades out-of-fold do treino
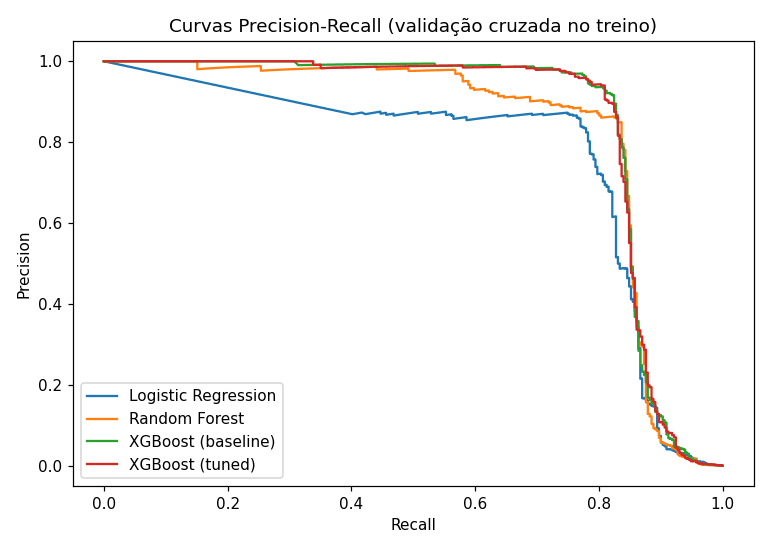
- Comparação por PR-AUC em vez de acurácia: prever sempre 'normal' acertaria cerca de 99,8% e seria inútil
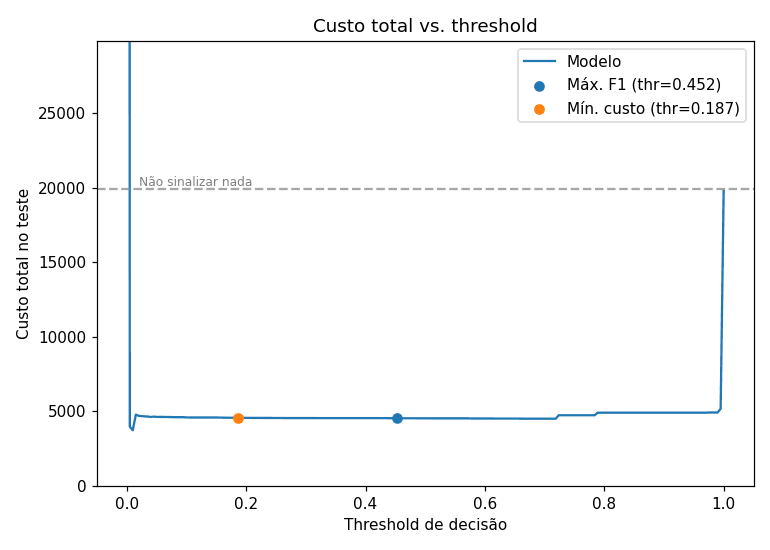
- Threshold por F1 e por custo de negócio: fraude perdida custa o valor da transação e revisar um alerta custa 5
- Intervalos de confiança por bootstrap, porque o teste tem só 142 fraudes
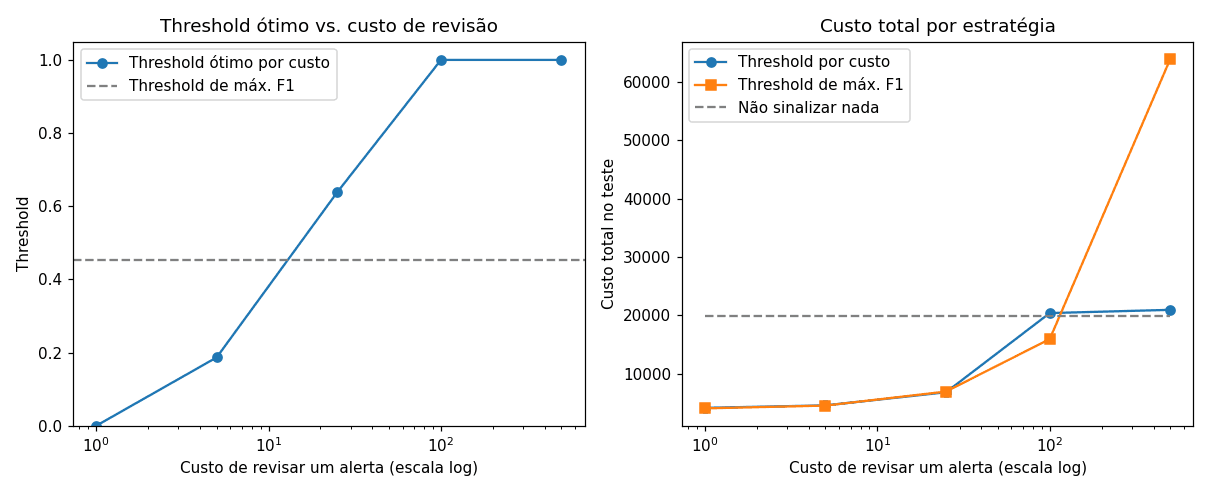
- Análise de sensibilidade ao custo de revisão (1, 5, 25, 100 e 500)
- Testes automatizados e integração contínua com GitHub Actions
Insights
- Acurácia engana em classes raras: a métrica certa aqui é PR-AUC
- Corrigir o vazamento da primeira versão reduziu a precisão de 97,2% para 90,0% no mesmo teste: o threshold tinha sido escolhido olhando o próprio teste
- O ajuste de hiperparâmetros não trouxe ganho: o XGBoost com parâmetros padrão empata com o ajustado (PR-AUC de 0,852 contra 0,850 na validação cruzada)
- O ganho depende do custo de revisão: economiza de 66% a 79% com revisão de 1 a 25, encolhe perto do valor médio de uma fraude (cerca de 140) e some com revisão a 500
- Anomalia não é fraude: a confirmação exige contexto adicional e investigação humana
Resultados
Sem vazamento de dados, o XGBoost detecta 108 das 142 fraudes do teste (recall de 76,1%, IC 95% de 68,6% a 82,5%) com 90,0% de precisão e reduz o custo total em cerca de 77% frente a não sinalizar nada.
- XGBoost com threshold de máx. F1 escolhido no treino: precision de 90,0%, recall de 76,1% e F1 de 0,824; PR-AUC de 0,810 (IC 95%: 0,748 a 0,870) e ROC-AUC de 0,976
- Teste com 85.118 transações e 142 fraudes: 120 alertas, dos quais 108 eram fraudes
- Custo total de 4.537 contra 19.878 se nada fosse sinalizado, uma redução de cerca de 77% com revisão a 5 por alerta
- Seleção na validação cruzada (PR-AUC): XGBoost 0,852, Random Forest 0,827 e Regressão Logística 0,736
Limitações
- Poucas fraudes no teste (142): os intervalos de confiança são largos, e diferenças pequenas entre modelos ou thresholds não são conclusivas
- O custo de revisão é uma premissa; escolher o threshold por custo no treino não garantiu custo menor no teste em todos os cenários
- Concept drift: o padrão de fraude muda e o modelo reflete o período do dataset (2013); o split aleatório não simula isso
- Um agente com conhecimento do modelo poderia desenhar transações abaixo do threshold
- Dataset público e anonimizado, usado estritamente para fins educacionais
Visualizações
Projetos relacionados
Telco Churn & Pricing: quem vale a pena contatar para reter
Previsão de cancelamento em uma operadora (7.043 clientes) transformada em decisão: probabilidades calibradas, regra de ganho esperado para escolher quem contatar e fila de retenção com os motivos de cada cliente.
Recomendador Multimodal: busca de produtos por imagem e texto com CLIP
Sistema de recomendação que encontra produtos parecidos a partir de uma foto, de uma descrição ou dos dois juntos: embeddings CLIP, busca por cosseno no ChromaDB, avaliação offline contra o acaso e app publicado no Streamlit.