A.X.E.L: assistente técnico com IA generativa local
Assistente para debug e otimização de Python e SQL, com interface de chat no navegador e na linha de comando, IA generativa local (Ollama) e arquitetura de Engenharia de Prompt em camadas.
Contexto
Nasceu como desafio do bootcamp DIO (Dados, IA Generativa e Cibersegurança) e evoluiu para uma implementação autoral, com foco em Engenharia de Prompt e arquitetura desacoplada.
Problema
Transformar descrições informais de bugs, lentidão ou erros em diagnósticos objetivos e acionáveis, sem exigir que a pessoa formule a pergunta de forma técnica.
Objetivo
Construir um assistente que roda localmente, com prompts organizados por responsabilidade, avaliação reprodutível a cada iteração e uma suíte de testes que roda sem o modelo.
Pipeline
- 1Entrada em linguagem natural
- 2Classificação de intenção
- 3Prompt em camadas
- 4LLM local (Ollama)
- 5Resposta estruturada
Processo técnico
- Prompts separados por responsabilidade: identidade, segurança, intenção e formato de resposta
- Regra de segurança que protege o system prompt mesmo sob tentativa de prompt injection
- Sem execução de código arbitrário fornecido pelo usuário
- Defesa em camadas contra vazamento do prompt: instrução de segurança, classificação de intenção e checagem da resposta no código
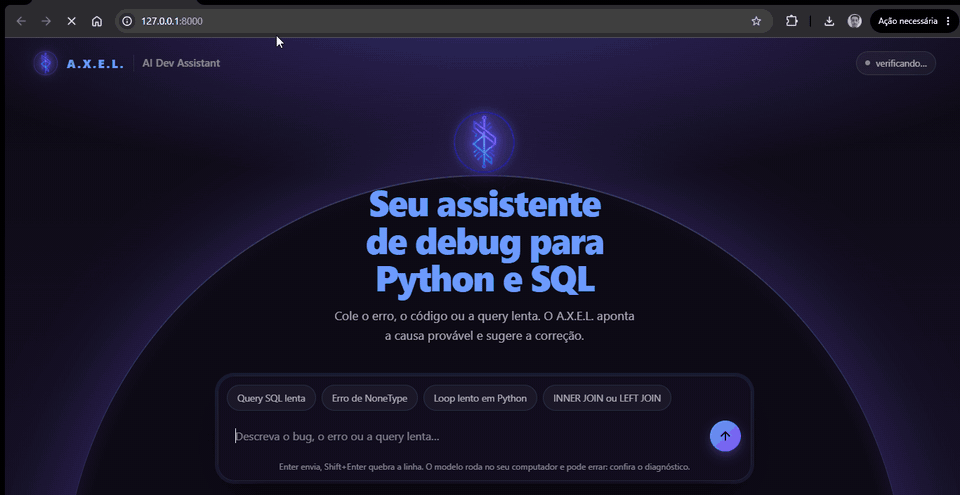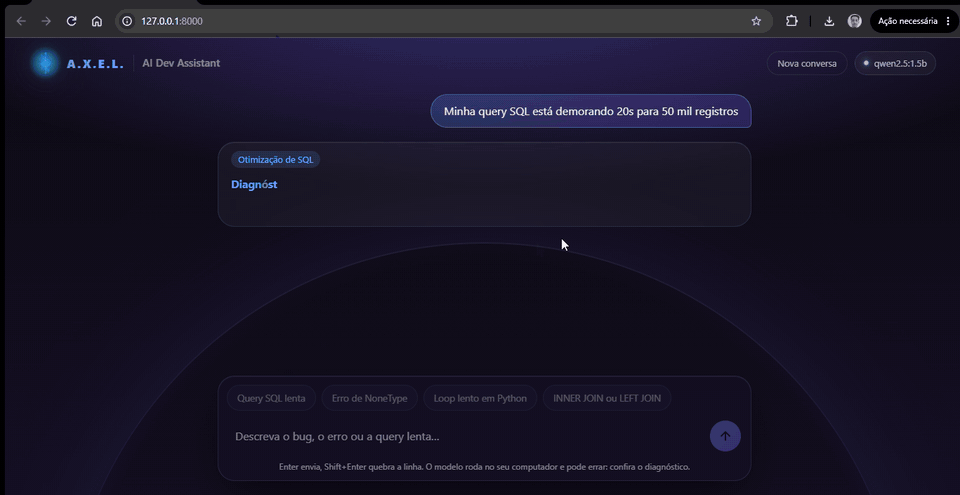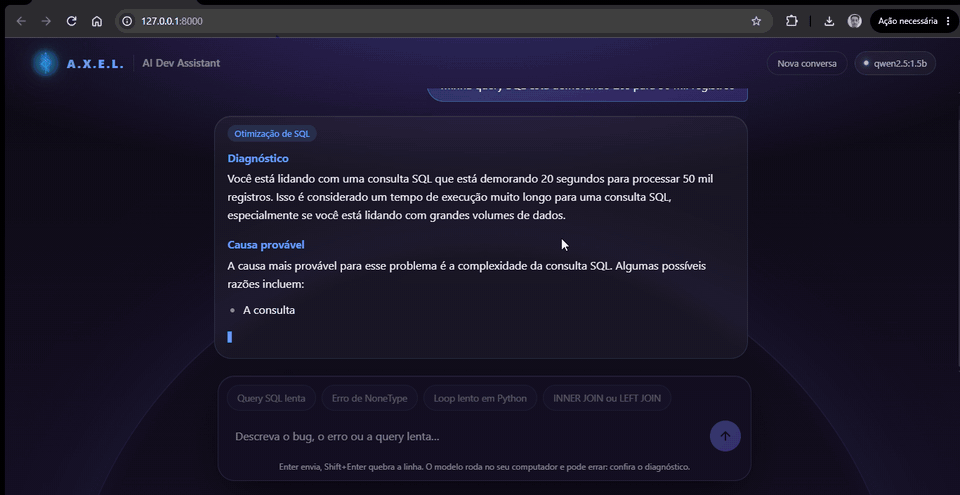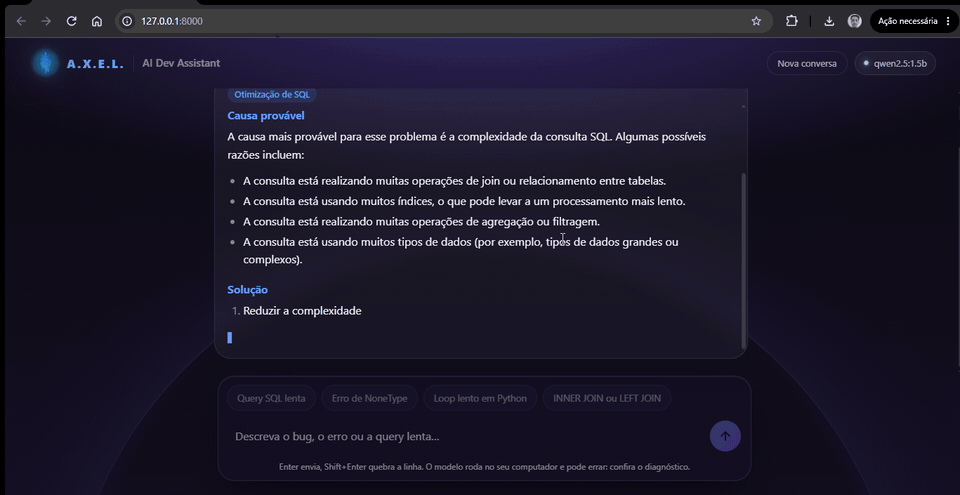
- Interface web local (FastAPI) com resposta em streaming, indicador de atividade e blocos de código com rolagem própria, usando o mesmo pipeline da linha de comando
- Detector de repetição no código: se o modelo pequeno entra em loop, a geração é interrompida e o usuário é avisado
- Mais de 65 testes unitários com um LLM simulado (pipeline, parsing, memória, prompts, segurança, API web) rodando em CI nas versões 3.11, 3.12 e 3.13 do Python, mais lint com Ruff
- Relatório de accuracy por script, com intervalo de confiança e quebra por intenção, a cada mudança de prompt
Insights
- Versionar e medir prompts permite saber se uma mudança melhorou ou piorou o resultado
- Persistir histórico é opt-in de propósito, pois significa guardar trechos de código em texto puro em disco
- Simular o LLM nos testes permite validar o pipeline inteiro de forma determinística e em milissegundos, deixando a avaliação com o modelo real para um script à parte
Resultados
O classificador de intenção acerta 14 de 16 pedidos (88%, IC 95% de 64% a 97%) com um modelo de 1,5 bilhão de parâmetros rodando local, e nenhuma das 10 tentativas de extrair o prompt interno vazou. Mais de 65 testes rodam em CI sem precisar do Ollama, e a resposta aparece em tempo real numa interface de chat local.
- Classificação de intenção: 88% (14/16) com qwen2.5:1.5b; os dois erros foram pedidos em que o modelo se apoiou na palavra "erro" ou em KeyError
- Segurança: 10 de 10 tentativas de extração sem vazamento no pipeline completo
- Com 16 casos, o intervalo de confiança é largo, então o número serve para acompanhar mudanças de prompt, não como taxa geral de acerto
Limitações
- A avaliação mede só a classificação da intenção, não a qualidade do diagnóstico gerado; o dataset é pequeno e escrito pelo próprio autor
- A checagem de vazamento compara trechos literais: um vazamento traduzido ou parafraseado não seria detectado
- O modelo local de 1,5 bilhão de parâmetros dá respostas genéricas e pode repetir trechos; o código corta os loops, mas a qualidade do diagnóstico depende do modelo
- Versão atual restrita a Python e SQL, com Ollama rodando localmente como pré-requisito e uma conversa por vez na interface web
- Roadmap: análise de dados como segundo domínio e um provider de API paga como alternativa ao Ollama
Visualizações
Projetos relacionados
Pipeline ETL para Feedbacks Bancários utilizando IA e PostgreSQL
Pipeline completo de Customer Experience sobre feedbacks sintéticos de um banco fictício (45 registros): ETL em PostgreSQL, auditoria de dados, KPIs de CX, score de priorização por tipo e canal e dashboard interativo de 4 páginas.
ETL da API VerdanaDesk
Pipeline de ETL que consome uma API externa, trata e modela os dados em um esquema dimensional preparado para consumo em BI.